名前付き集計と reset_index
次のコードを実行したときの出力として、正しいものを1つ選べ。
import pandas as pd
df = pd.DataFrame({"k": ["a", "a", "b"], "v": [1, 3, 5]})
print(df.groupby("k").agg(n=("v", "count"), m=("v", "mean")).reset_index().columns.tolist())- A
['n', 'm'] - B
['k', 'v'] - C
['k', 'n', 'm'] - D
['index', 'n', 'm']
正解と解説を見る
正解:C
groupby().agg(新しい名前=(列, 関数)) の結果は、グループのキーがインデックスになる。reset_index() で列に戻せる。
| 順 | 実行する行 | 実行後の変数 |
|---|---|---|
| 1 | `import pandas as pd` | — |
| 2 | `df = pd.DataFrame({"k": ["a", "a", "b"], "v":…` | df = DataFrame(3行×2列) |
| 3 | `print(df.groupby("k").agg(n=("v", "count"), m…` | df = DataFrame(3行×2列) |
| 結果 | 実際の出力 | ['k', 'n', 'm'] |
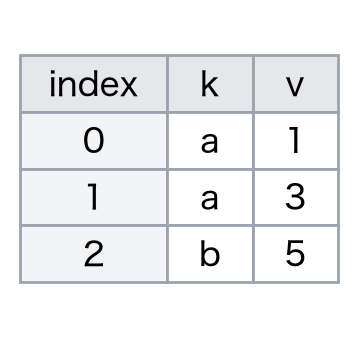
- A
誤り。
reset_indexでキーkが列になる。 - B
誤り。名前付き集計で、列名が決まる。
- C
正しい。
reset_indexでグループのキーが列に戻る。 - D
誤り。キーの名前
kが列名になる。
このサイトの問題は、各試験の公式に示された出題範囲に沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。一般社団法人Pythonエンジニア育成推進協会の公式サービスではありません。