標準偏差による外れ値検出の限界
次のコードを実行したときの出力として、正しいものを1つ選べ。
import pandas as pd
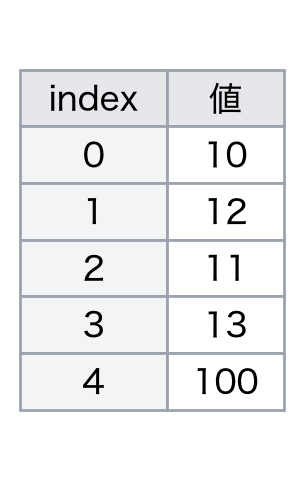
s = pd.Series([10, 12, 11, 13, 100])
print(int(((s - s.mean()).abs() <= 2 * s.std()).sum()))- A
4 - B
1 - C
5 - D
0
正解と解説を見る
正解:C
標準偏差を使う方法は、外れ値自身が平均や標準偏差を押し上げて、見逃すことがある(マスキング)。サンプルが少ないときや、外れ値が極端なときは、中央値と MAD や IQR を使う。
| 順 | 実行する行 | 実行後の変数 |
|---|---|---|
| 1 | `import pandas as pd` | — |
| 2 | `s = pd.Series([10, 12, 11, 13, 100])` | s = [10, 12, 11, 13, 100] |
| 3 | `print(int(((s - s.mean()).abs() <= 2 * s.std(…` | s = [10, 12, 11, 13, 100] |
| 結果 | 実際の出力 | 5 |
- A
誤り。100 は 2 標準偏差以内に収まる。
- B
誤り。外れ値以外の 4 つも範囲内。
- C
正しい。外れ値の 100 自身が、平均と標準偏差を大きくするので、100 も範囲内になり、1 つも外れ値として検出されない(マスキング)。
- D
誤り。全部が範囲内。
このサイトの問題は、各試験の公式に示された出題範囲に沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。一般社団法人Pythonエンジニア育成推進協会の公式サービスではありません。