インデックスによる join
次のコードを実行したときの出力として、正しいものを1つ選べ。
import pandas as pd
a = pd.DataFrame({"x": [1, 2]}, index=["p", "q"])
b = pd.DataFrame({"y": [3, 4]}, index=["q", "r"])
print(a.join(b).values.tolist())- A
[[1.0, nan], [2.0, 3.0]] - B
[[2.0, 3.0]] - C
[[1.0, 3.0], [2.0, 4.0]] - D
[[1.0, nan], [2.0, 3.0], [nan, 4.0]]
正解と解説を見る
正解:A
DataFrame.join は、既定でインデックスを使った左結合。列をキーにするなら merge が向く。
| 順 | 実行する行 | 実行後の変数 |
|---|---|---|
| 1 | `import pandas as pd` | — |
| 2 | `a = pd.DataFrame({"x": [1, 2]}, index=["p", "…` | a = DataFrame(2行×1列) |
| 3 | `b = pd.DataFrame({"y": [3, 4]}, index=["q", "…` | b = DataFrame(2行×1列) |
| 4 | `print(a.join(b).values.tolist())` | a = DataFrame(2行×1列), b = DataFrame(2行×1列) |
| 結果 | 実際の出力 | [[1.0, nan], [2.0, 3.0]] |
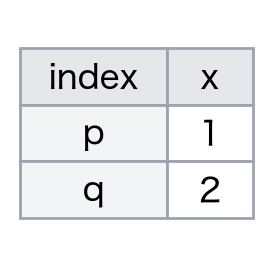
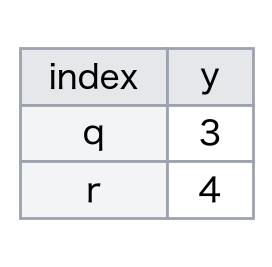
- A
正しい。
joinは既定でインデックスをキーにした左結合。pには対応する行がないので欠損になる。 - B
誤り。左側の行はすべて残る(左結合)。
- C
誤り。インデックスが一致する行どうしが結合される。
- D
誤り。外部結合の結果。
このサイトの問題は、各試験の公式に示された出題範囲に沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。一般社団法人Pythonエンジニア育成推進協会の公式サービスではありません。